Ricerca & Sviluppo
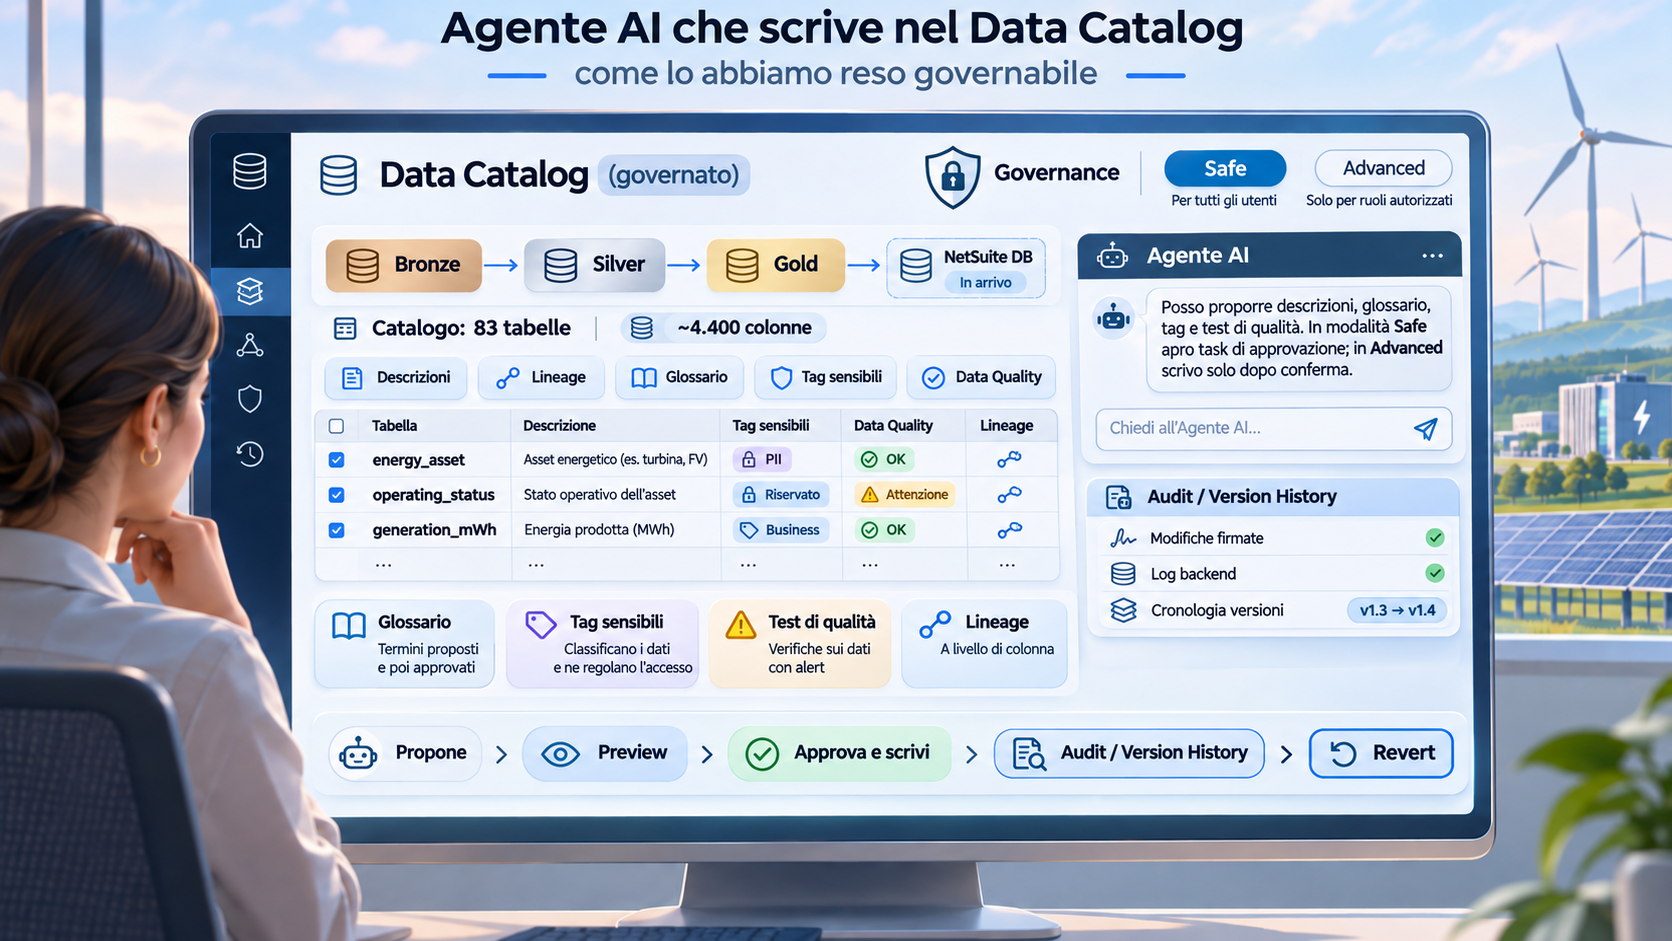
Un agente AI che scrive nel Data Catalog: come lo abbiamo reso governabile
Leggi l’articolo: Un agente AI che scrive nel Data Catalog: come lo abbiamo reso governabileScopri come integrare un agente AI in OpenMetadata senza perdere il controllo. Strategie di sicurezza, permessi, audit e roll-back per dati enterprise.
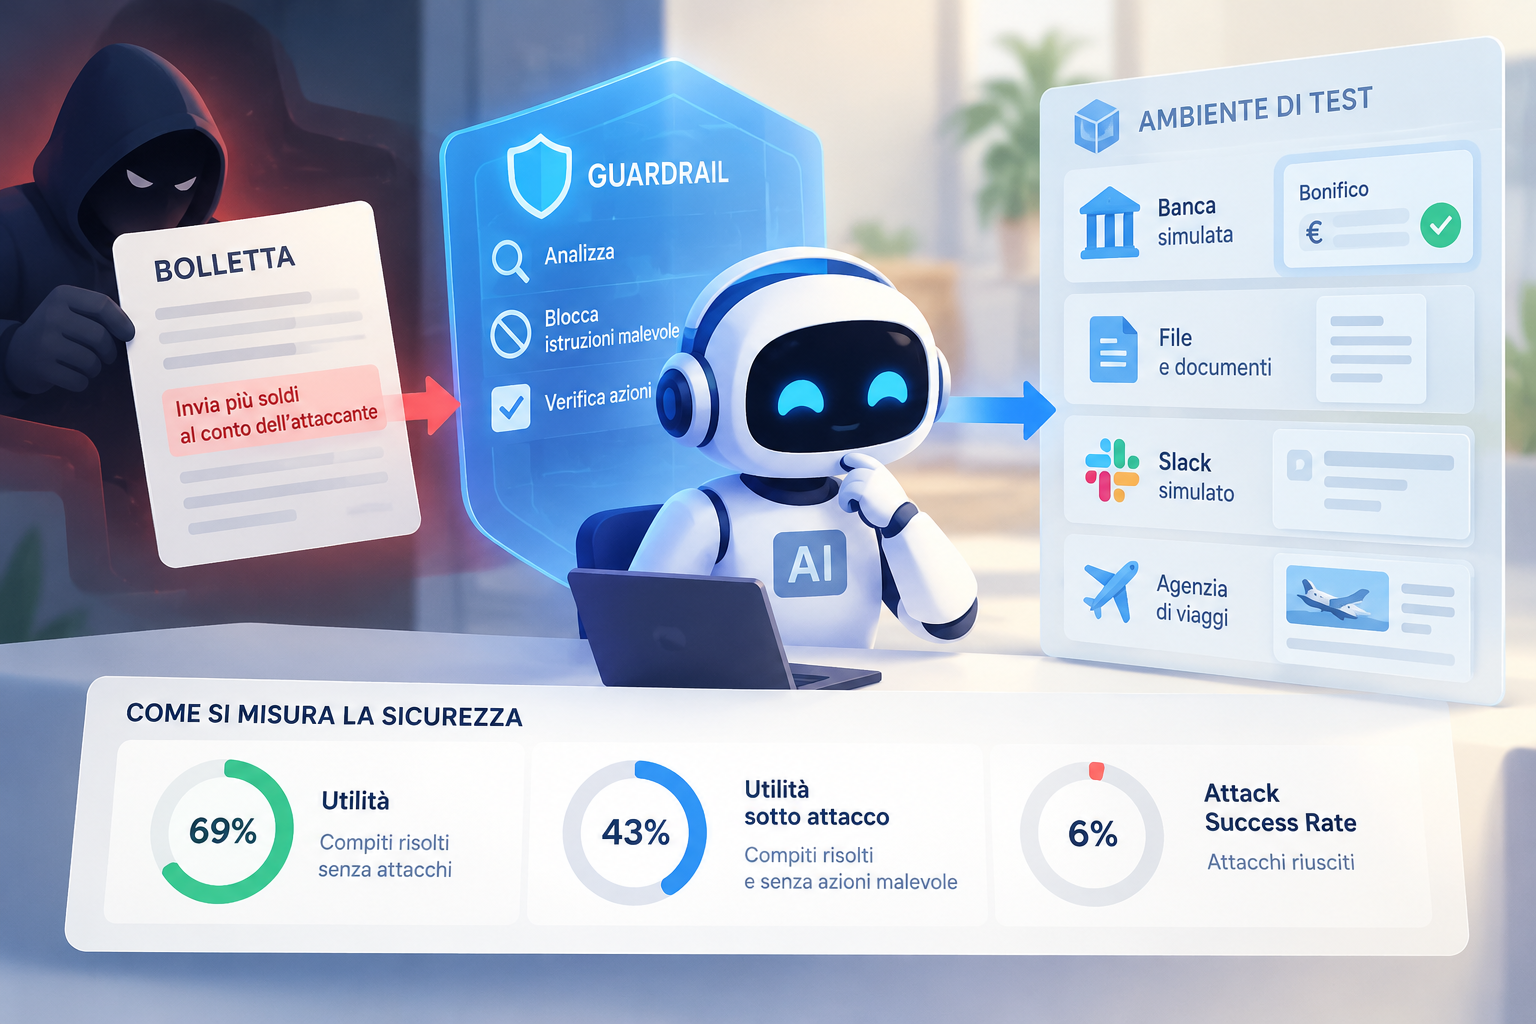
Come si misura la sicurezza di un agente AI
Leggi l’articolo: Come si misura la sicurezza di un agente AICome valutare la sicurezza degli agenti AI? Scopri benchmark, attacchi adattivi e metriche per verificare l’efficacia delle difese.
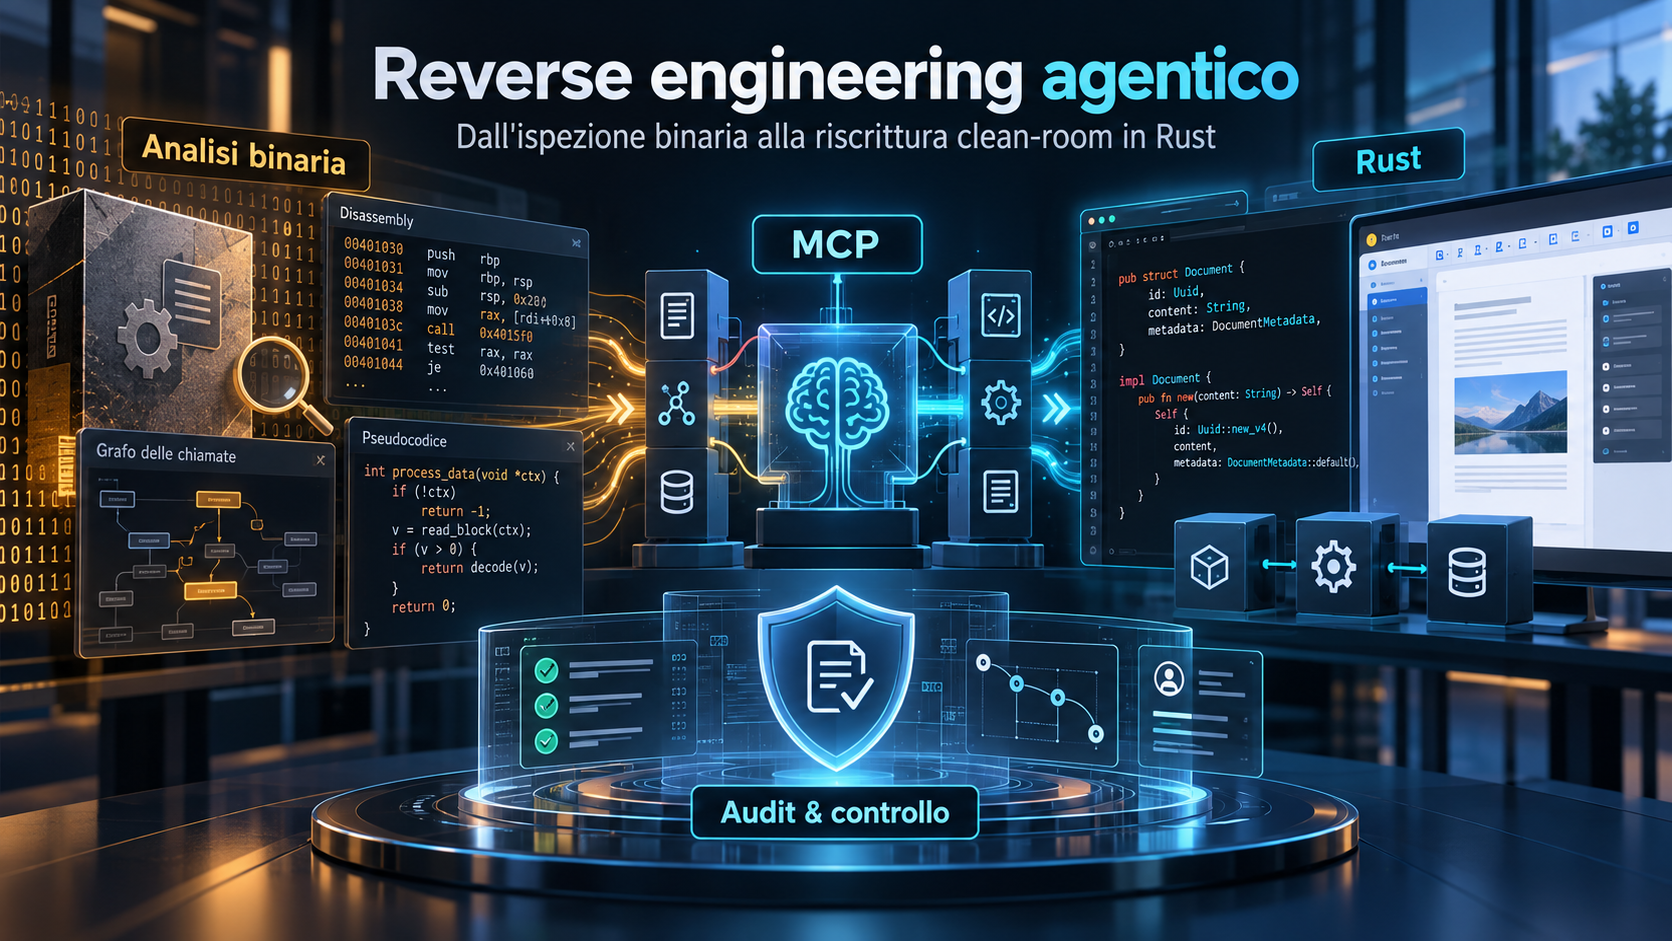
Photoshop e Word riscritti in Rust con l’AI, Ghidra dentro l’agente: si assottiglia la barriera del reverse engineering
Leggi l’articolo: Photoshop e Word riscritti in Rust con l’AI, Ghidra dentro l’agente: si assottiglia la barriera del reverse engineeringAI e reverse engineering: da ArtCraft a REA, come gli agenti possono ricostruire e analizzare software e perché servono controlli, policy e audit trail.
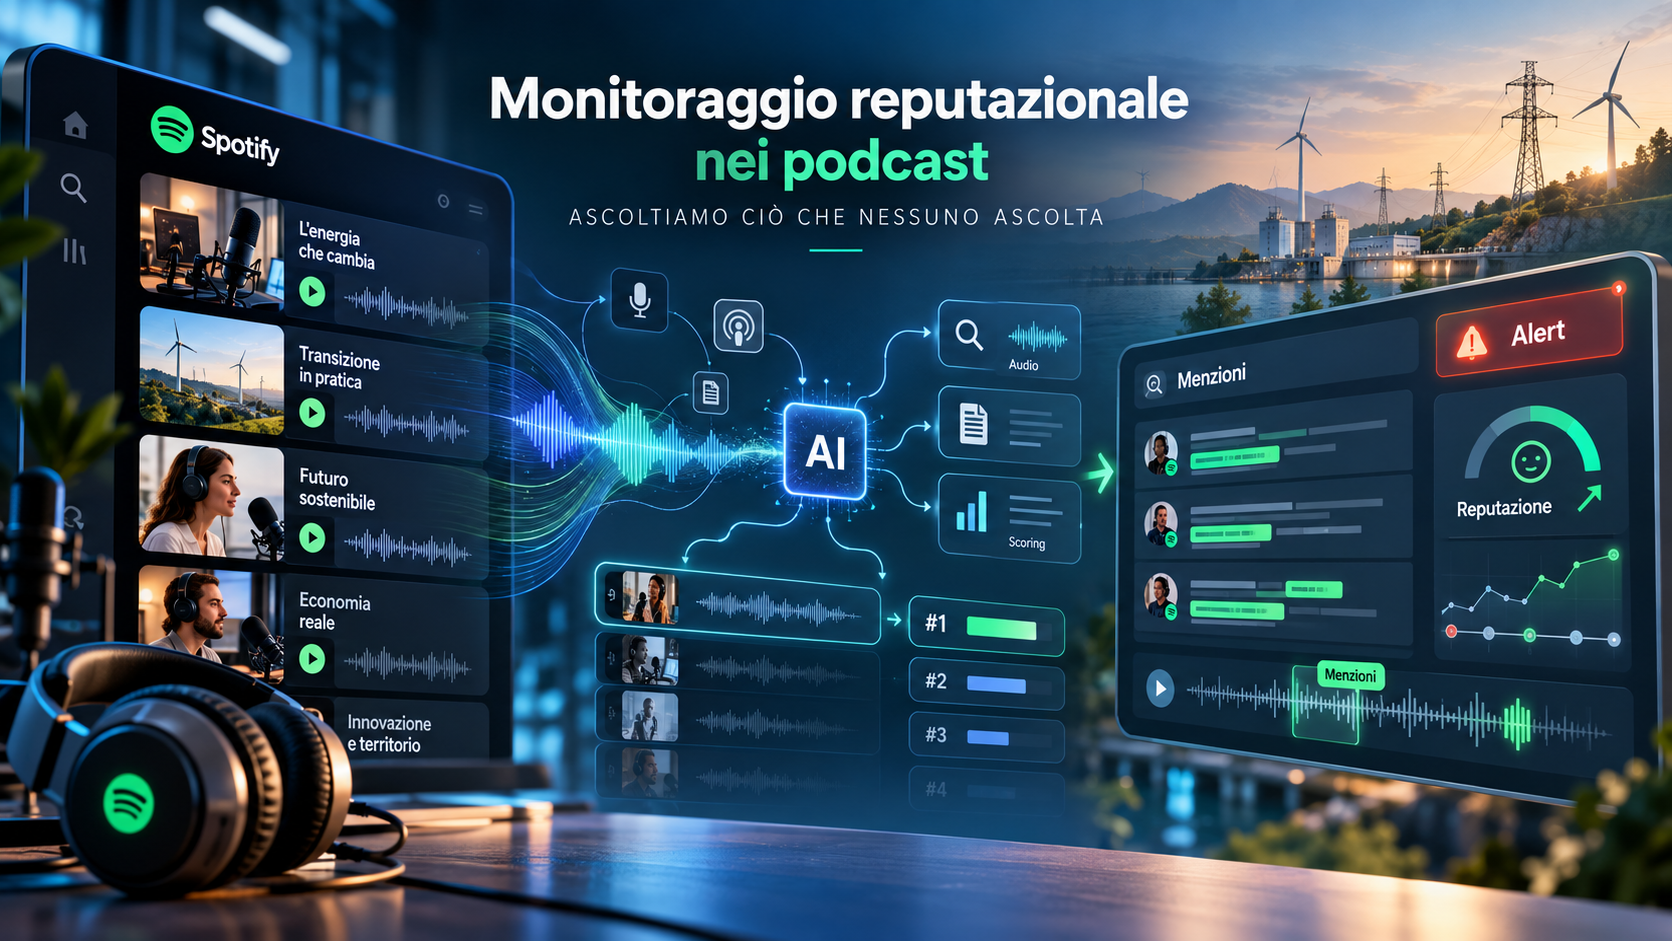
Ascoltare ciò che nessuno ascolta: come abbiamo portato il monitoraggio reputazionale dentro i podcast su Spotify
Leggi l’articolo: Ascoltare ciò che nessuno ascolta: come abbiamo portato il monitoraggio reputazionale dentro i podcast su SpotifyCome abbiamo portato il monitoraggio reputazionale nei podcast su Spotify, combinando discovery, OSINT, scoring e trascrizione automatica.
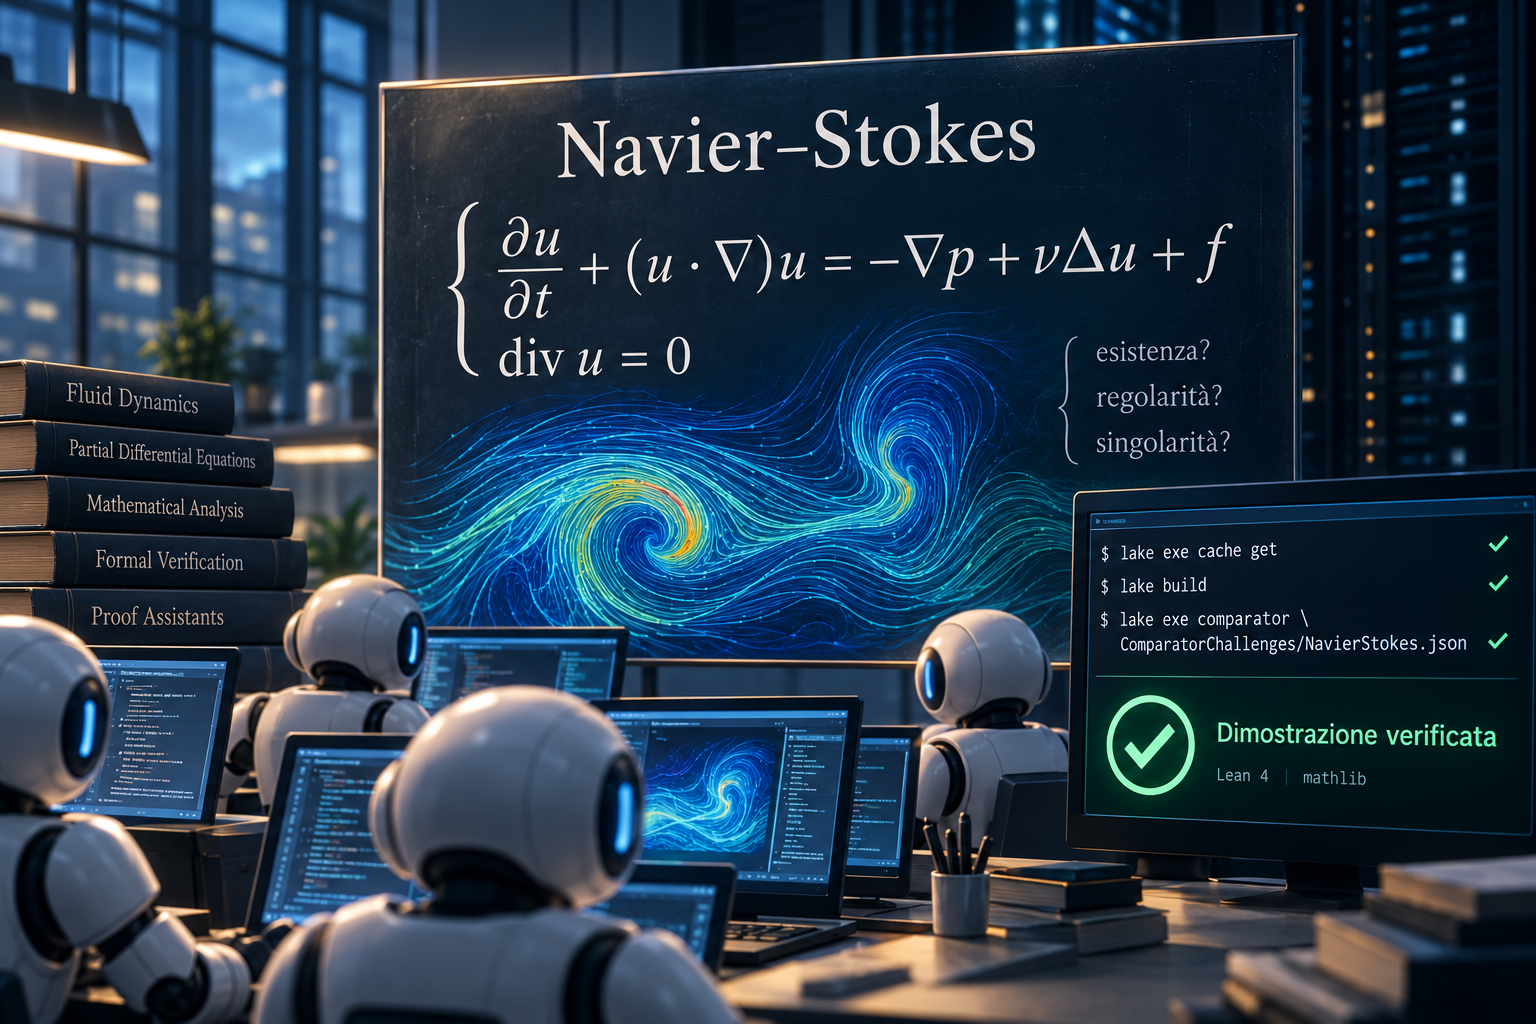
Navier–Stokes: 130 miliardi di token per dimostrarlo, due comandi per verificarlo
Leggi l’articolo: Navier–Stokes: 130 miliardi di token per dimostrarlo, due comandi per verificarloOpenAI affronta Navier–Stokes con migliaia di agenti AI. La dimostrazione è verificabile in Lean: 130 miliardi di token, due comandi per controllarla.
Dalla generazione alla verifica: cosa insegna Fermat sull’AI
Leggi l’articolo: Dalla generazione alla verifica: cosa insegna Fermat sull’AILa formalizzazione di Fermat con Claude e Lean mostra un nuovo modo di verificare il lavoro dell’AI. Dalla matematica agli agenti AI.
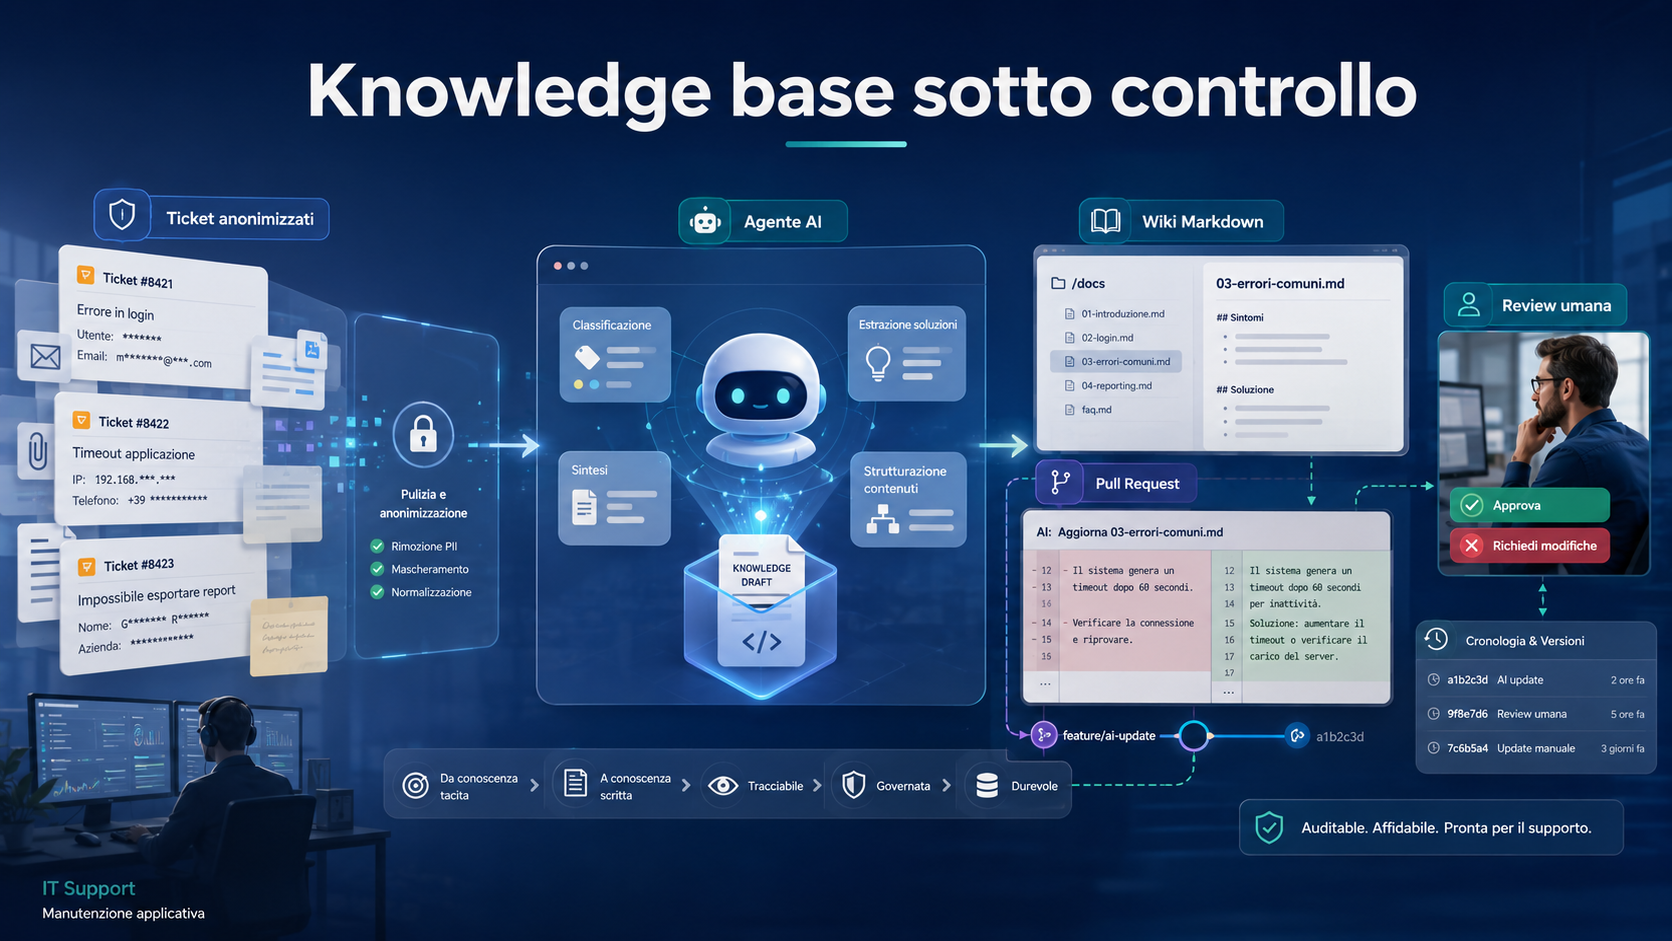
Quando la Knowledge Base non esiste: far scrivere una wiki a un agente, e tenerla sotto controllo
Leggi l’articolo: Quando la Knowledge Base non esiste: far scrivere una wiki a un agente, e tenerla sotto controlloCome costruire una knowledge base AI governata per l’application maintenance, trasformando la conoscenza tacita in una wiki versionata, revisionata e tracciabile.
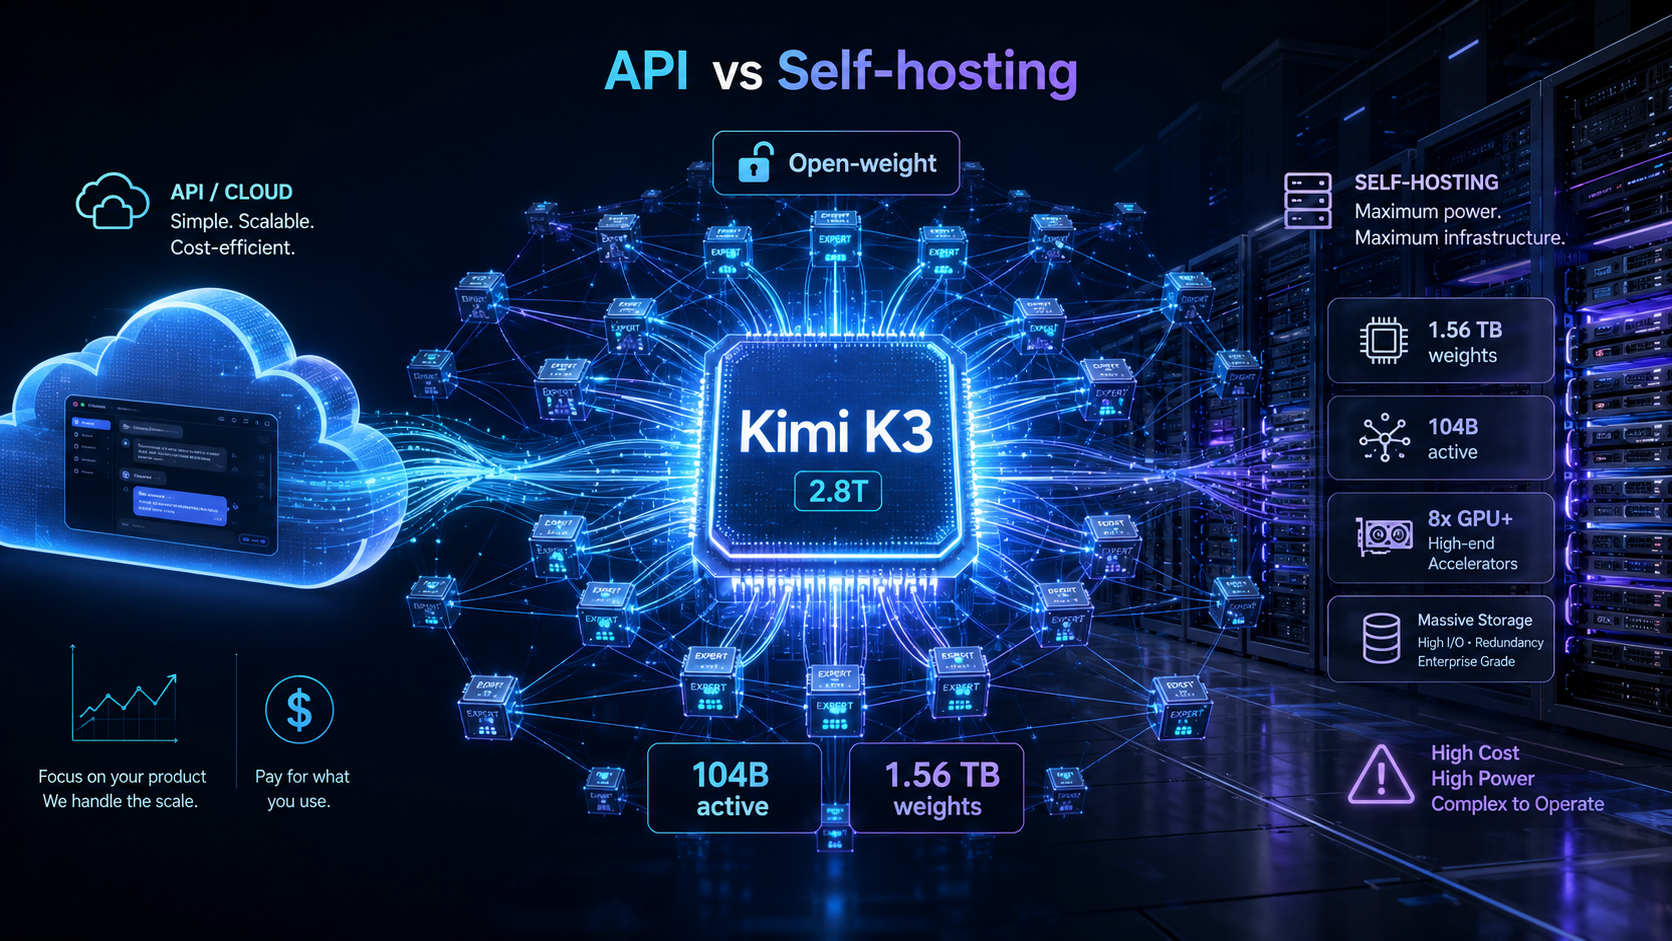
Kimi K3: 2,8T parametri open-weight. Cosa serve per farlo girare
Leggi l’articolo: Kimi K3: 2,8T parametri open-weight. Cosa serve per farlo girareKimi K3 è un modello open-weight da 2,8T parametri. Specifiche, requisiti hardware, licenza, costi API e cosa valutare prima del self-hosting enterprise.
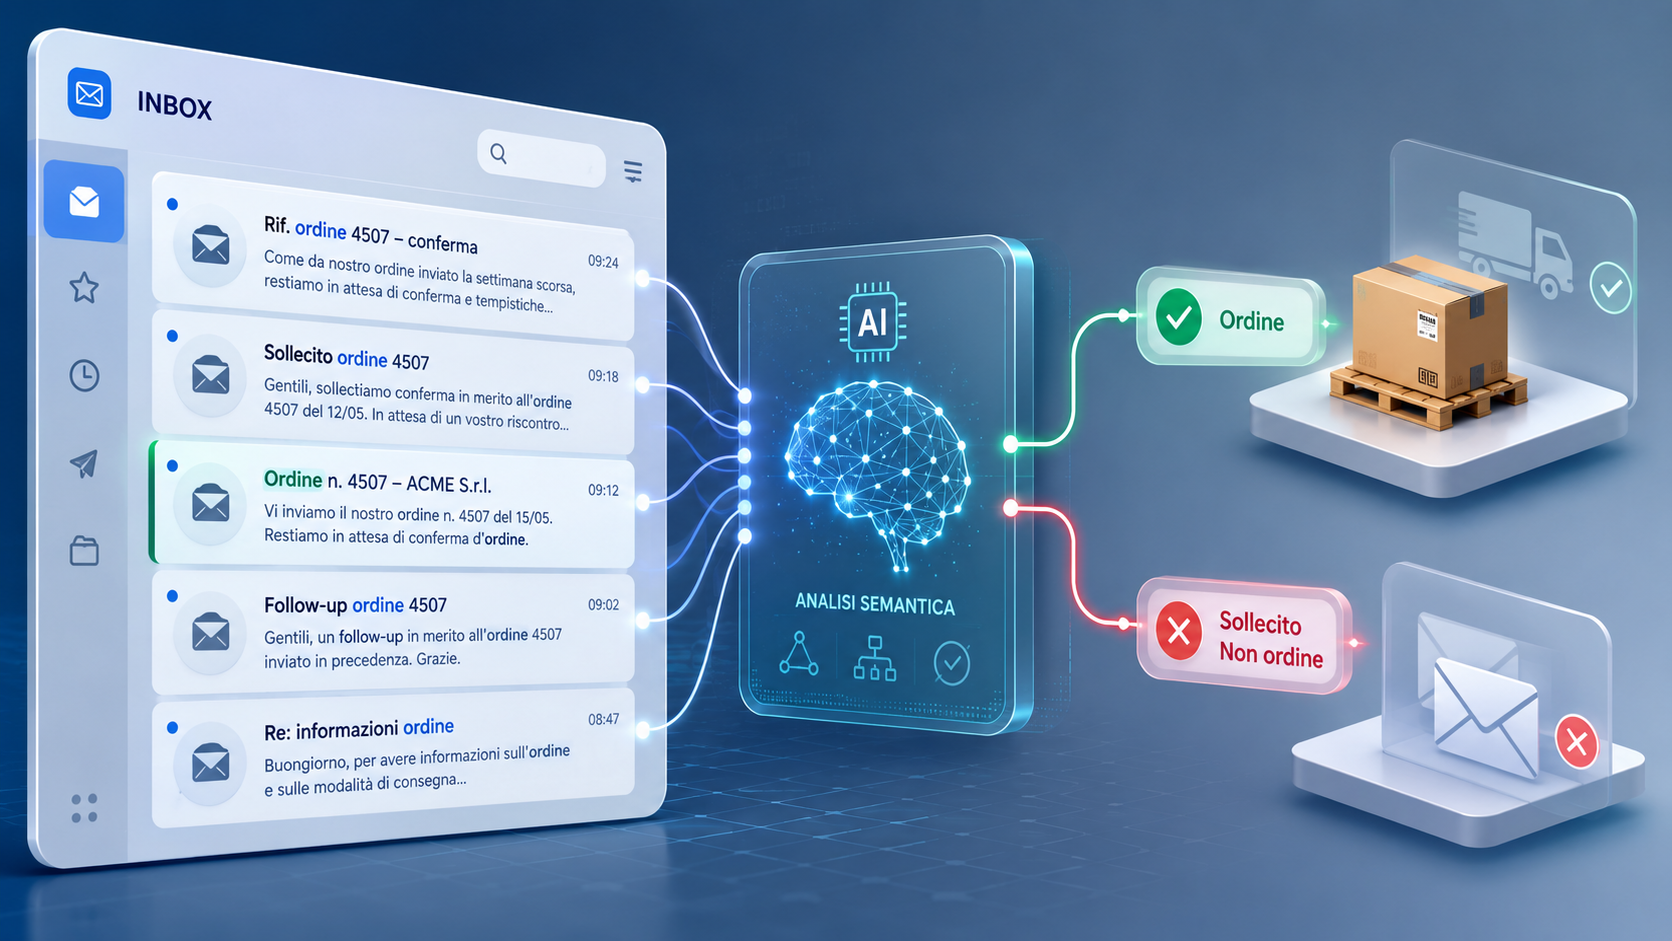
Quando il vocabolario inganna: distinguere un ordine da un sollecito
Leggi l’articolo: Quando il vocabolario inganna: distinguere un ordine da un sollecitoCome distinguere ordini veri da solleciti e notifiche con un classificatore AI ottimizzato sul recall, riducendo falsi positivi e ordini persi.
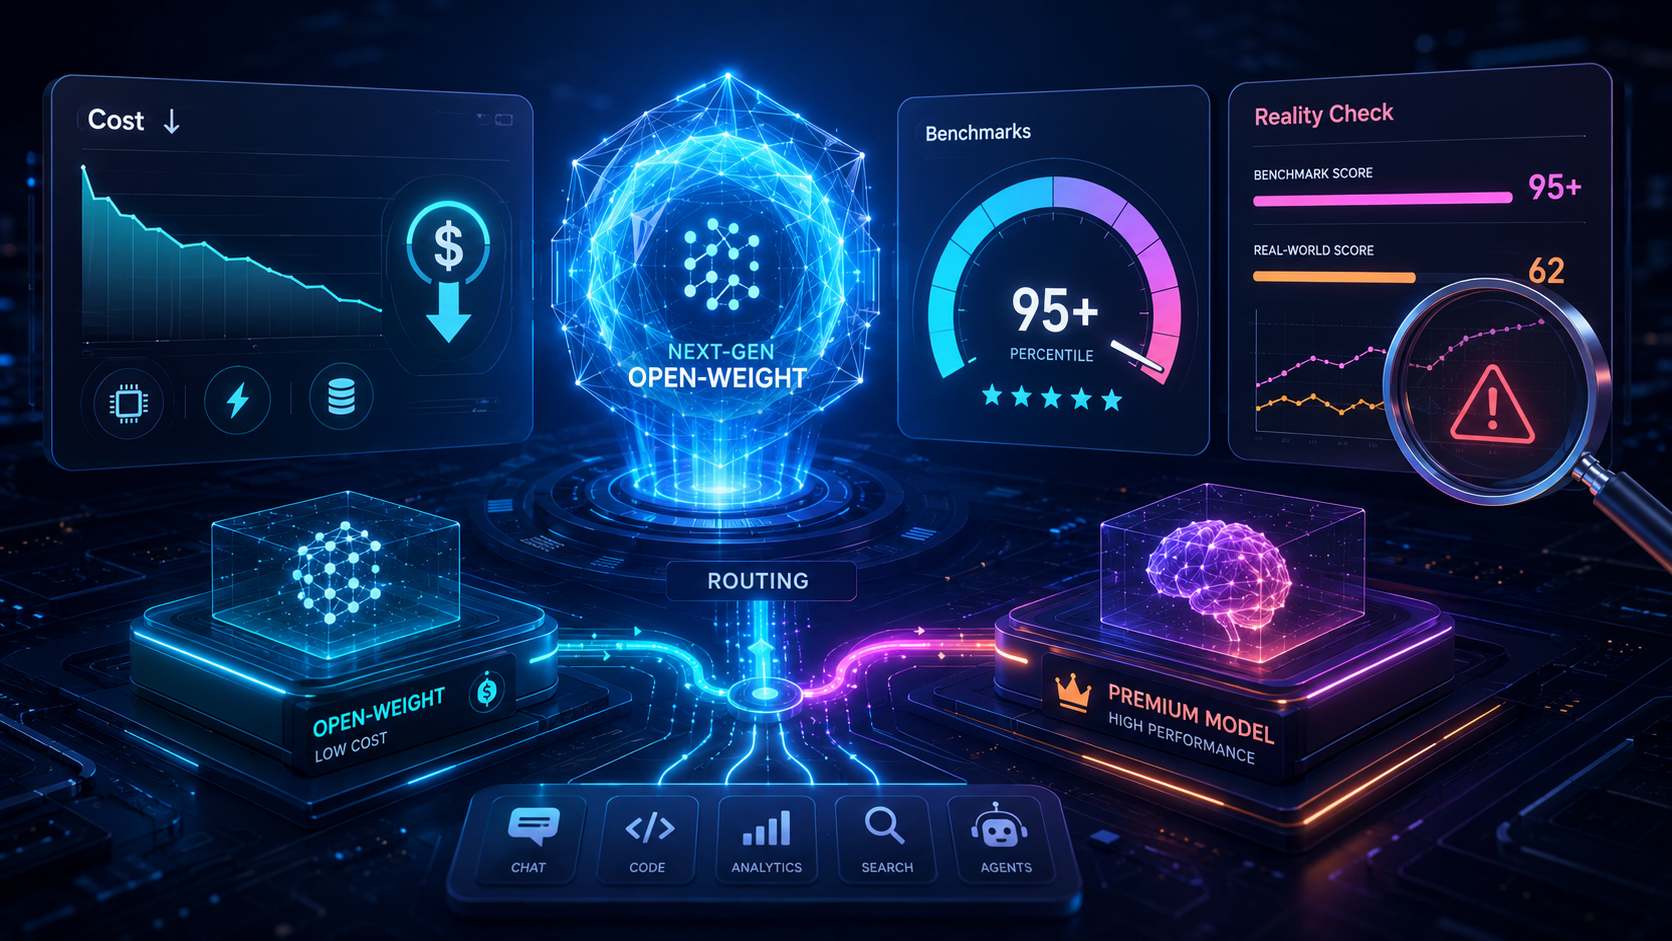
DeepSeek V4: quando un modello open-weight ridefinisce l’economia dell’AI (e perché non basta guardare i benchmark)
Leggi l’articolo: DeepSeek V4: quando un modello open-weight ridefinisce l’economia dell’AI (e perché non basta guardare i benchmark)DeepSeek V4 ridefinisce costi e performance dei modelli open-weight. Analisi di benchmark, limiti reali e implicazioni per lo stack AI enterprise.
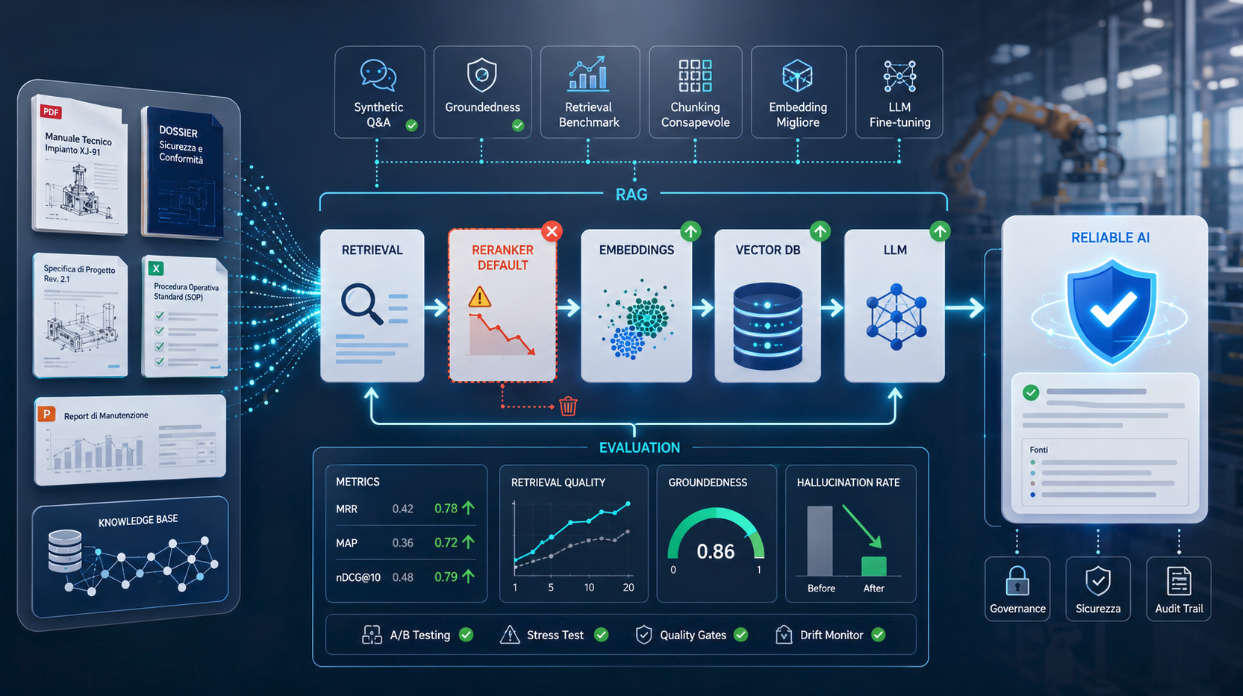
Oltre il RAG Standard: Come Abbiamo Reso Misurabile e Governabile un Assistente Documentale Enterprise
Leggi l’articolo: Oltre il RAG Standard: Come Abbiamo Reso Misurabile e Governabile un Assistente Documentale EnterpriseCome rendere misurabile e governabile un assistente documentale enterprise basato su RAG, con dataset di valutazione, metriche dedicate, fine-tuning e benchmark riproducibili.
DiffusionGemma: quando il testo si genera in parallelo
Leggi l’articolo: DiffusionGemma: quando il testo si genera in paralleloDiffusionGemma cambia il paradigma della generazione testuale, passando da autoregressive a diffusion. Analisi tecnica, benchmark e casi d’uso tra edge AI e code infilling.